
Multiverse Computing 在 Hugging Face 发布文章,介绍论文《Safety for Whom? Boundary-Aware Self-Distillation for Controlled LLM Safety Refusal》。研究关注一个具体问题:模型面对政治等敏感主题时,能否拒绝操纵性劝说等有害请求,同时继续回答选举制度等事实性问题。
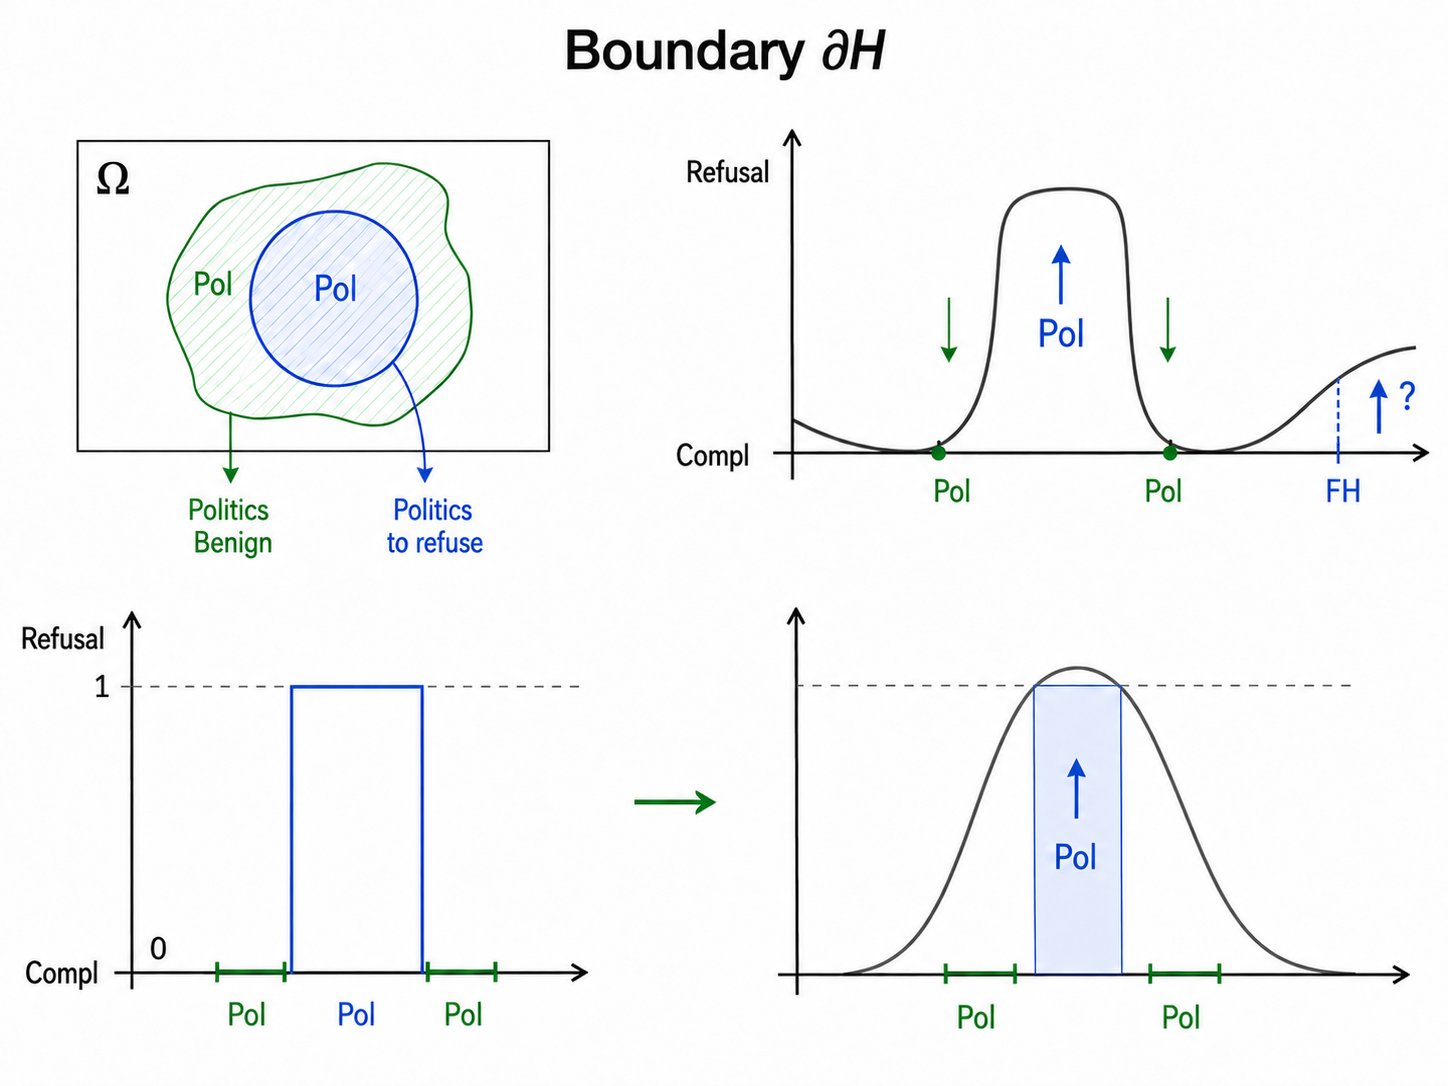
研究团队认为,按主题划分的安全策略容易把“主题危险”与“请求意图”混为一谈。为测试更细的边界,团队把共享同一主题、但意图不同的一对提示词用于评估,并将政治劝说作为实验场景。
文章称,传统的单次自生成流程会丢弃未能生成合格拒答的样本。在其审计数据中,单次生成漏掉了19.88%的提示词,即8,009条;采用逐步增强的重试策略后,剩余失败样本降至0.20%,即79条,并保留40,293条有害训练提示词。团队还加入11,955条来自18类、表面上带有危险措辞但实际无害的提示词,用于衡量和缓解过度拒答。
在 Qwen3-8B 的实验中,升级数据覆盖后的模型将分布内政治内容的拒答率从9.47%提高到84.75%。文章同时报告,最强配置下,HarmBench、StrongREJECT 和 WildJailbreak 三项基准的平均不安全回答率从26.26%降至0.14%;但同一检查点在 XSTest 上的过度拒答率也从2.00%升至74.00%。这些结果表明,单看有害请求拒答率,可能掩盖模型对安全请求的误拒答。文章所述结果来自该研究团队的实验,尚不能据此推断所有模型或部署场景都会出现相同幅度的变化。